¿Cómo puede ser tan rápido y a la vez pensar tanto?
¿Cómo es posible que Gemini 3.8 Flash sea igual de rápido y barato que la versión 3.7, pero programe mucho mejor y resuelva tareas complejas sin ayuda?
Esa es la sorpresa que Google presentó el 2 de septiembre de 2026. No lanzó un modelo gigante y caro. Lanzó un modelo Flash, de los rápidos, que ahora razona antes de responder. Y junto a él, una variante gemela para seguridad: Gemini 3.8 Flash Cyber.
Explicación sencilla
Gemini 3.8 Flash es el nuevo modelo principal de Google para el trabajo diario con IA. Está optimizado para ingeniería de software, tareas agénticas y razonamiento complejo. Es decir, para escribir código, encadenar varios pasos, usar herramientas y no perderse en el camino.
Gemini 3.8 Flash Cyber comparte la misma inteligencia fundamental, pero está especializado en ciberseguridad. Su tarea es detectar vulnerabilidades de forma autónoma y ayudar a aplicar parches. No es público. Su acceso está restringido a gobiernos y socios de confianza a través del programa Fairwind.
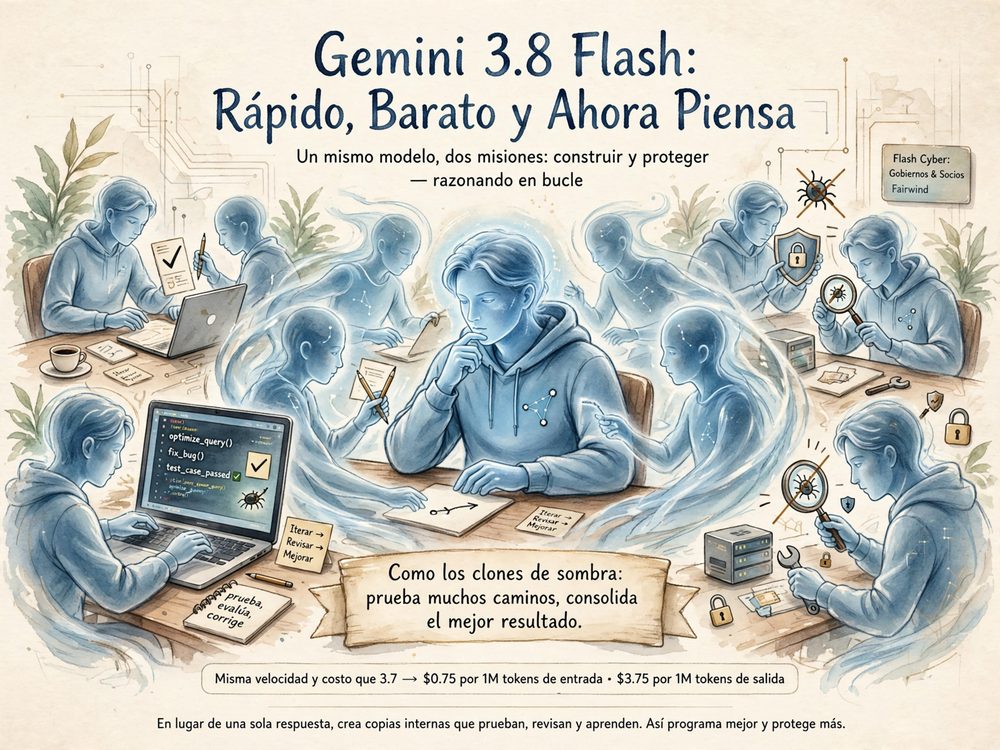
La idea central es una sola: un mismo modelo base con dos asignaciones. Uno para construir y razonar, otro para proteger. Y ambos mantienen la velocidad y el costo de la generación anterior: 0.75 dólares por millón de tokens de entrada y 3.75 dólares por salida.
Una analogía
Piensa en Naruto y su técnica de los clones de sombra. Naruto no resuelve una misión difícil enviando a un solo Naruto que lo intenta una vez. Crea decenas de clones, cada clon prueba un camino distinto, pelea, falla, aprende, y luego todos esos aprendizajes regresan al Naruto original. El original se queda con lo mejor de cada intento.
Gemini 3.8 Flash hace eso durante toda esta explicación. No da la primera respuesta que se le ocurre. Despliega esas copias internas, prueba soluciones, las revisa y solo al final entrega el resultado consolidado. Esa analogía nos va a acompañar para entender todo lo demás.
¿Cómo funciona realmente?
Esta es la parte más importante. Gemini 3.8 Flash y 3.8 Flash Cyber utilizan bucles de agentes de larga duración para refinar sus respuestas de forma recursiva.
En un modelo tradicional rápido, el proceso era lineal: recibe la instrucción, genera el texto, termina. En Gemini 3.8 Flash, el proceso es circular. El modelo recibe la instrucción, genera un borrador interno, lo evalúa, detecta errores, llama a una herramienta si necesita verificar algo, corrige el borrador y repite el ciclo. Solo cuando el resultado pasa sus propias pruebas, lo muestra al usuario.
Por eso mejora tanto en programación sin subir de precio. El costo por token no cambió respecto a 3.7, pero el uso de esos tokens sí cambió. En lugar de gastar todos los tokens en una respuesta larga de una sola vez, los reparte entre esos clones internos que prueban, verifican y corrigen.
Ambos modelos comparten esa capacidad. La diferencia está en el entrenamiento y los permisos. El Flash general está ajustado para código, instrucciones largas y uso de herramientas en plataformas como Google AI Studio, Android Studio, la API de Gemini, Google Antigravity y GitHub Copilot. El Flash Cyber está ajustado con datos y entornos de seguridad para reconocer patrones de ataque, explorar código vulnerable y proponer una corrección aplicable. Los clones son los mismos, solo cambia la misión que les asignan.
Este fue el tercer lanzamiento de la línea Flash en seis semanas, lo que muestra el ritmo actual: no se busca solo un modelo más grande, se busca un modelo rápido que sepa revisar su propio trabajo en bucle.
Ejemplos
Ejemplo 1, de menor dificultad: ordenar y explicar una función.
Un estudiante abre Android Studio y le pide a Gemini 3.8 Flash: "Explica esta función en Java que ordena una lista de usuarios y hazla más rápida".
El modelo no responde de inmediato. Uno de sus clones internos propone usar sort con un comparador, otro clon detecta que la función original falla si la lista tiene valores nulos, otro clon verifica la sintaxis con la herramienta de análisis. Al final el usuario recibe una sola respuesta limpia: explicación en lenguaje simple, código corregido y aviso del error de nulos. Rápido por fuera, revisado por dentro.
Ejemplo 2, de mayor dificultad: un agente que audita un repositorio.
Un equipo pequeño conecta Gemini 3.8 Flash en GitHub Copilot o en Antigravity y le pide: "Revisa este repositorio, encuentra por qué falla el inicio de sesión y deja una propuesta lista para revisión".
Aquí los clones trabajan en serie larga. Un clon mapea los archivos, otro reproduce el error, otro rastrea la función de autenticación, otro descubre que una dependencia valida mal un token expirado, otro escribe una prueba que reproduce el fallo, otro redacta el parche. El usuario no ve decenas de intentos, ve el informe final con causa, prueba y corrección. En la variante Cyber, ese mismo flujo se enfoca en seguridad: descubrir la vulnerabilidad explotable y preparar el parche, pero dentro de entornos controlados y solo para usuarios autorizados de Fairwind.
Errores comunes
Muchas personas creen que Gemini 3.8 Flash Cyber ya está disponible para todos en la API. No lo está. Es de acceso restringido.
Otro error: creer que porque es Flash, es un modelo simple que no razona. En esta versión, la velocidad no significa ausencia de revisión. Significa revisión interna rápida.
Idea clave
Gemini 3.8 Flash no acierta por ser más rápido, acierta porque envía a sus clones a fallar por dentro antes de responder por fuera.
Datos importantes
Les dejo por acá el benchmark y la presentación del modelo qué publica el equipo de Google
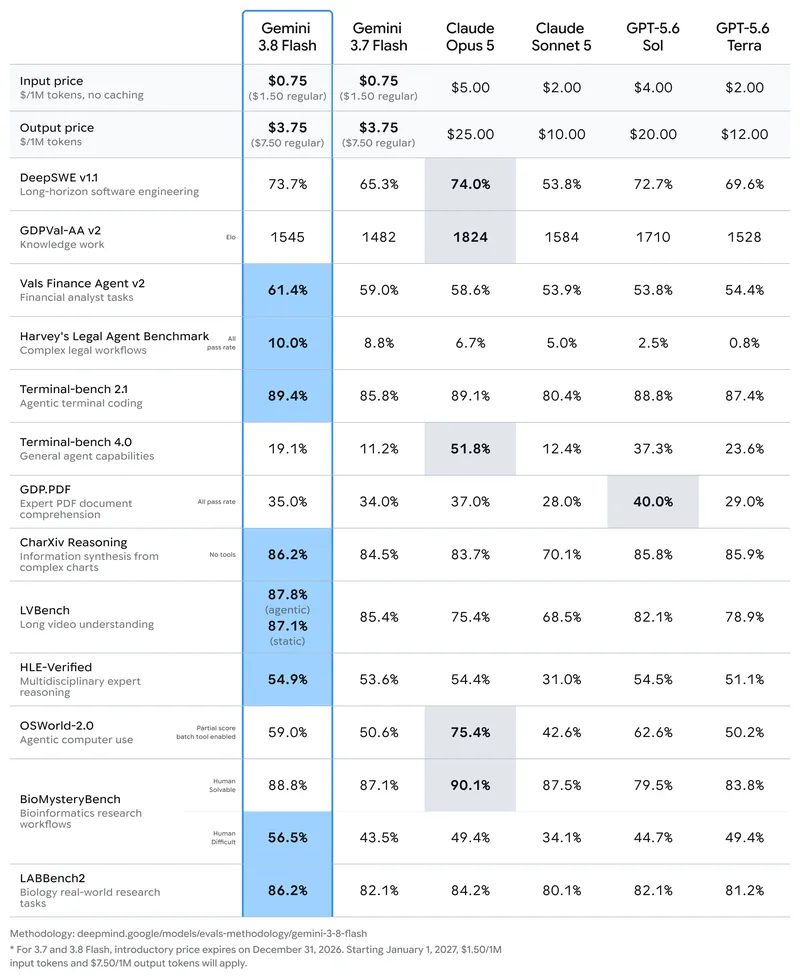
Gemini 3.8 : modelo